غوغل تكشف شريحتي TPU 8tx و8i Max.. معالجان في حزمة واحدة لمواجهة اختناق الذاكرة
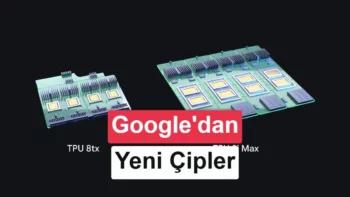
أضافت غوغل شريحتي TPU 8tx وTPU 8i Max إلى الجيل الثامن من معالجات Tensor Processing Unit المخصصة لأحمال الذكاء الاصطناعي، مع تركيز الأولى على حماية البيانات الحساسة أثناء المعالجة، واستهداف الثانية لمشكلة اختناق الذاكرة في النماذج التي تتعامل مع سياقات تضم ملايين الرموز.
وبذلك تكون الشركة قد كشفت خلال عام واحد عن أربعة أنظمة من عائلة TPU. ولا تعتمد النماذج الجديدة على بنية سيليكون مختلفة، بل توظف سيليكون الجيل الثامن نفسه ضمن تكوينات عتادية محسّنة لأحمال محددة، في محاولة لتعزيز حضور غوغل لدى العملاء من المؤسسات.
TPU 8tx لحماية البيانات أثناء المعالجة
صممت غوغل نموذج TPU 8tx للجهات الحكومية والمؤسسات المالية والشركات التي تفرض متطلبات صارمة لأمن البيانات. وتضم الشريحة ميزات أمان عتادية تهدف إلى حماية نماذج الذكاء الاصطناعي عند تشغيلها على بيانات حساسة.
تُشفّر البيانات عادةً أثناء تخزينها أو نقلها عبر الشبكات، لكنها تحتاج إلى فك تشفيرها داخل الذاكرة عندما يعالجها المعالج، وهو ما يترك نقطة تعرض محتملة. وتعالج TPU 8tx هذه المشكلة على مستوى العتاد؛ إذ بُنيت على السيليكون نفسه المستخدم في تبو 8t، وتعمل مع معالجات AMD EPYC من الجيل الخامس، بما يسمح بعزل البيانات الحساسة وأوزان النماذج وحمايتها أثناء تنفيذ العمليات.
كما تستخدم الشريحة شبكة Boardfly منخفضة زمن الاستجابة، التي طورتها غوغل لعمليات الاستدلال والتفكير الفوري. ووفقًا للشركة، توفر هذه البنية زمن استجابة أقل بما يصل إلى الضعف مقارنةً بـ TPU 8t، مع إبقاء تراجع الأداء قريبًا من الصفر.
وكانت غوغل قد قدمت في أبريل شريحة TPU 8t لتدريب نماذج الذكاء الاصطناعي الكبيرة، بينما خصصت TPU 8i للاستدلال منخفض زمن الاستجابة وعمليات التفكير الآني. وقالت الشركة إن النظامين السابقين يقدمان، مقارنةً بالجيل السابق، أداءً أفضل في التدريب يصل إلى 2.7 ضعف، وتحسنًا بنسبة 80% في نسبة الأداء إلى السعر لعمليات الاستدلال.
شريحتان في حزمة واحدة لمواجهة اختناق الذاكرة
أما TPU 8i Max، فتستهدف النماذج التي تعمل على سياقات طويلة جدًا، مثل تحليل عدد كبير من وكلاء الذكاء الاصطناعي لقاعدة برمجية ضخمة، أو معالجة مقاطع فيديو تمتد لساعات في الوقت نفسه. وفي هذه السيناريوهات، تصبح سرعة نقل البيانات من الذاكرة وإليها عاملًا يحد من أداء المعالجة.
ولمعالجة هذا القيد، جمعت غوغل شريحتي TPU 8i منخفضتي زمن الاستجابة داخل حزمة واحدة. وتوفر TPU 8i Max ضعف قوة المعالجة، وضعف ذاكرة SRAM، وضعف عرض نطاق ذاكرة HBM مقارنةً بإصدار TPU 8i القياسي.
وتقول الشركة إن التصميم يتيح للمعالجات الوصول إلى البيانات المطلوبة بسرعة أكبر، ما يقلل تباطؤ أحمال العمل الكبيرة أثناء انتظار نقل البيانات من الذاكرة. كما يسمح وضع الشريحتين ضمن المساحة نفسها على الرف بتحقيق كثافة معالجة أعلى لكل وحدة مساحة وطاقة داخل مراكز البيانات.
تحديثات برمجية لإدارة منظومة TPU
لا تقتصر توسعة غوغل على العتاد، إذ أطلقت الشركة تحديثات في منظومة البرمجيات لتسهيل استخدام شرائح TPU. ومن خلال أداة TorchTPU مفتوحة المصدر، يمكن تشغيل شيفرات PyTorch ونماذج Hugging Face على شرائح TPU من دون تعديلها.
وأتاحت غوغل أيضًا حزمة وكلاء TPU المتكاملة مع Claude Code وCursor وGoogle Antigravity، بهدف أتمتة تحسينات العتاد. وتشمل الأدوات الجديدة كذلك XLA Serving Engine، الذي يتيح تقديم النماذج عبر TPU وGPU وCPU، وAgent Compute Engine الذي يحرر موارد المعالجة التي لا يستخدمها وكلاء الذكاء الاصطناعي في الوقت الحالي.
وتجمع أداة TPU Sync مفتوحة المصدر موارد HBM وDRAM والتخزين ضمن تسلسل هرمي موحد للذاكرة. وتهدف غوغل من خلال ذلك إلى خفض زمن نقل بيانات KV، وتقليص الوقت اللازم لإنتاج الرمز الأول بأكثر من 90%.
ولإدارة مجموعات TPU الكبيرة عبر Google Kubernetes Engine، طرحت الشركة ميزتي Cloud Pathways وDynamic Slicing للاستخدام العام. وتعتمد Dynamic Slicing على تقنية التبديل البصري للدوائر، أو OCS، لإعادة تهيئة مجموعات TPU بصورة ديناميكية، ما يقلص زمن بدء المهام بما يصل إلى خمس مرات، ويسرّع استعادة العمل بعد الأعطال بما يصل إلى 4.5 مرات.
وتستخدم غوغل أدوات ذكاء اصطناعي مثل AlphaChip وGemini في تصميم أجيال TPU الجديدة. ووفقًا للشركة، يستطيع Gemini اختصار أعمال توزيع مكونات الشريحة من أسابيع إلى ساعات.
غياب اختبارات الأداء والأسعار حتى الآن
لم تكشف غوغل بعد عن اختبارات أداء تفصيلية لشريحة TPU 8i Max، أو أرقام استهلاك الطاقة، أو الأسعار. لذلك لا يمكن في الوقت الحالي إجراء مقارنة دقيقة بين النظام الجديد ومنصات إنفيديا Rubin من حيث الكفاءة والتكلفة.
المصدر: donanimhaber
https://x.com/Google/status/2119788086490001906