إنفيديا تطلق 4 نماذج مفتوحة لاختبار السيارات والروبوتات.. لماذا لا تكفي المحاكاة وحدها؟
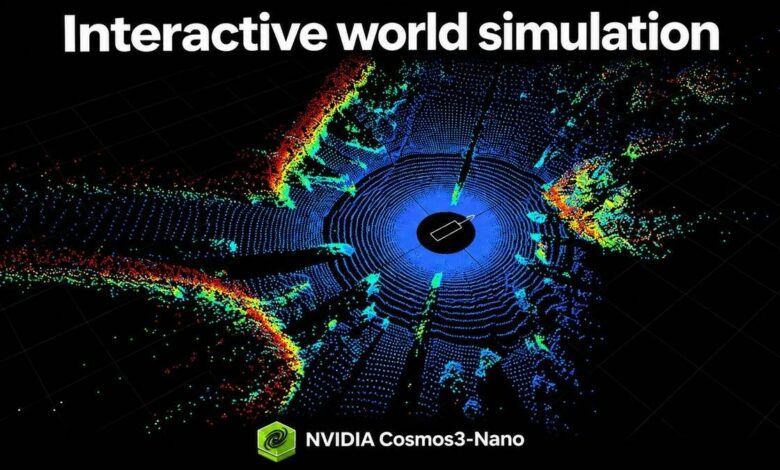
أعلنت شركة إنفيديا في 5 نوفمبر 2026 إضافة أربعة نماذج جديدة إلى عائلة NVIDIA Cosmos 3، لمساعدة مطوري السيارات ذاتية القيادة والروبوتات على اختبار سيناريوهات معقدة داخل بيئات افتراضية قبل نقلها إلى العالم الحقيقي. وتأتي النماذج بأوزان مفتوحة، ما يتيح للباحثين والمطورين الوصول إلى أوزانها وتكييفها مع بياناتهم وأنظمتهم الخاصة.
وتنتمي النماذج إلى سلسلة Cosmos3-Nano، التي تعتمد على تقنية «نماذج العالم» القادرة على توقع خصائص البيئة الفيزيائية ونتائج الحركات التي تُنفذ داخلها. ووفقًا لما نشرته الشركة على منصة «إكس»، تقدم إنفيديا هذه الأدوات بوصفها مساعدين لفرق تطوير السيارات ذاتية القيادة، في إشارة إلى عبارتها الترويجية: Meet your new AV development pit crew.
لماذا تحتاج السيارات ذاتية القيادة إلى بيانات اصطناعية؟
يواجه مطورو القيادة الذاتية تحديًا كبيرًا يتمثل في اختبار عدد هائل من الحالات المحتملة على الطرق، بما في ذلك تغيرات الطقس والإضاءة، وتصميمات الطرق، وإشارات المرور، وتحركات المركبات الأخرى. ويستغرق جمع البيانات من الطرق الفعلية وقتًا وموارد كبيرة، بينما يصعب أو يستحيل أحيانًا إعادة إنشاء بعض السيناريوهات الخطرة بشكل متكرر في حركة المرور الحقيقية.
تستهدف Cosmos 3 هذه المشكلة عبر إنتاج بيانات اصطناعية، أي بيانات اختبار تُنشأ بواسطة الحاسوب. ويمكن للنظام توليد صور لما قد تراه الكاميرات، إلى جانب البيانات التي تلتقطها مستشعرات مختلفة، بما يسمح للمطورين بفحص ظروف قيادة متعددة افتراضيًا قبل اختبارها بواسطة مركبات فعلية.
لكن ذلك لا يعني أن المحاكاة ستلغي الاختبارات الواقعية. فالسيناريوهات التي ينتجها النموذج تحتاج إلى التحقق من مدى توافقها مع الواقع الفيزيائي، كما لا يمكن افتراض أن النماذج تمثل جميع ظروف العالم الحقيقي بالدقة نفسها.
ما الذي يفعله كل نموذج؟
يركز النموذج Cosmos3-Nano-Transfer-Auto على إنتاج فيديو متعدد الكاميرات وبيانات المستشعرات انطلاقًا من سيناريوهات القيادة الذاتية. ويمكنه إنشاء فيديو متزامن من 11 زاوية كاميرا، مع دعم كاميرات عين السمكة، وإنتاج صور RGB وبيانات LiDAR معًا.
وتستخدم تقنية LiDAR أشعة الليزر لرصد البنية ثلاثية الأبعاد للبيئة وقياس المسافات. وباستخدام النموذج، يستطيع المطورون تغيير الطقس والإضاءة ووقت اليوم لبناء حالات قيادة متنوعة.
أما Sim-Auto، فيركز على محاكاة القيادة التفاعلية. إذ ينتج لقطات الكاميرا وقراءات LiDAR في مقاطع متتابعة، استنادًا إلى التغييرات في أوامر القيادة. فإذا تغير اتجاه مركبة افتراضية مثلًا، يمكن للنموذج إنشاء قراءات مستشعرات جديدة تتوافق مع الوضع المعدل. ومع ذلك، فإن إنشاء محاكاة كاملة مغلقة الحلقة يتطلب بيئة تشغيل ومكونات تحكم إضافية.
ويحوّل نموذج Cosmos3-Nano-Sim-Transfer البيانات الناتجة عن محاكيات الفيزياء التقليدية إلى مخرجات بصرية. ففي هذه البنية، يحسب محاكي الفيزياء حركات الأجسام ومواقعها، ثم يستخدم Cosmos تلك المعلومات لإنشاء صور RGB. كما يدعم النموذج مدخلات تحكم مختلفة، مثل العمق، وتقسيم الأجسام، ومعلومات الحواف، ما يفصل بين حساب الحركة الفيزيائية وإنتاج المشاهد الواقعية.
أما النموذج الرابع، Cosmos3-Nano-Sim-Bimanual، فيتخصص في الروبوتات ذات الذراعين. ويتوقع النموذج كيف ستتغير البيئة بصريًا بعد تنفيذ الروبوت لحركة معينة، كما يدعم تكوينات روبوتية من نوعي YAM وAgiBot. ويمكن توجيه الحركات بواسطة أنظمة تحكم آلية أو عبر وحدات تحكم يستخدمها الإنسان، ما يتيح فحص مهام مثل إمساك الأشياء ونقلها داخل بيئة افتراضية.
المحاكاة لا تعني أن الصورة الجميلة كافية
لا تقتصر أهمية النماذج الجديدة على قدرتها على إنشاء مشاهد تبدو واقعية. ففي أنظمة القيادة الذاتية، يجب أن تتوافق الصورة التي تلتقطها الكاميرا مع المعلومات الهندسية التي يرصدها مستشعر LiDAR، لأن إنتاج صورة جذابة بصريًا لا يضمن أن البيانات مناسبة لاتخاذ قرار قيادة صحيح.
وتحاول عائلة Cosmos3-Nano إنتاج أنواع متعددة من البيانات بصورة متسقة. وبذلك يمكن للمطورين اختبار الطريق نفسه في أجواء مختلفة، مثل المطر والضباب أو مستويات إضاءة متباينة، وزيادة تنوع سيناريوهات الاختبار.
وتختلف المحاكاة التفاعلية عن إنتاج الفيديو التقليدي؛ ففي الفيديو التقليدي يكون مسار المشهد محددًا مسبقًا، بينما تؤثر الحركة المنفذة في النظام التفاعلي على اللقطة التالية. ويتيح ذلك دراسة الحالات التي قد تواجهها خوارزميات القيادة الذاتية بعد اتخاذ قرارات مختلفة.
فإن هذا النهج قد يوسع نطاق الاختبارات، لكنه لا يقدم بحد ذاته دليلًا مباشرًا على مستوى السلامة الذي ستحققه المركبات في الشوارع. فمدى تأثير النماذج سيتضح بصورة أكبر بعد إخضاع نتائجها لعمليات تحقق تنفذها فرق البحث والشركات المصنعة.
16 مليار معامل ومتطلبات تشغيل محددة
بُنيت النماذج الأربعة على معمارية Cosmos 3 Nano، ويضم كل نموذج منها 16 مليار معامل قابل للتدريب، وفقًا للشرح التقني الذي قدمته إنفيديا. وتمثل المعاملات قيمًا رقمية يتعلم النموذج من خلالها العلاقات أثناء التدريب، لكن عددها وحده لا يحدد دقة المحاكاة أو سرعتها؛ إذ تعتمد النتائج أيضًا على العتاد المستخدم، والنموذج المحدد، وسيناريو الاختبار.
استخدمت إنفيديا أسلوب تدريب متعدد المراحل. ففي البداية تُكيّف النماذج اعتمادًا على بيانات متاحة، ثم تتعلم توقع مقاطع بصرية جديدة انطلاقًا من الملاحظات السابقة. وفي مراحل لاحقة، يجري العمل على تسريع إنتاج الصور وتقليل الأخطاء التي قد تنتقل من التوقعات السابقة.
وتكتسب هذه النقطة أهمية خاصة في المحاكاة الطويلة، إذ يمكن للأخطاء الصغيرة أن تتراكم مع مرور الوقت وتؤثر في النتيجة النهائية. لذلك يتضمن أسلوب التدريب طرقًا تستهدف الحد من هذا التراكم.
وتُطرح النماذج الجديدة بأوزان مفتوحة بموجب ترخيص OpenMDW 1.1، الذي يدعم الاستخدام التجاري وغير التجاري عند الالتزام بشروطه. غير أن وصفها بأنها مفتوحة الأوزان لا يعني أنها بلا قيود أو أنها ستعمل على أي جهاز.
وتتطلب تجربة محاكاة الروبوتات، على وجه الخصوص، نظام Linux، ووحدة معالجة رسومية من إنفيديا، وDocker، وأداة NVIDIA Container Toolkit. وذكرت الشركة أن نسخة Sim-Bimanual المنشورة اختُبرت على جهاز GB200، مع التأكيد على أن ذلك لا يمثل الحد الأدنى المطلوب للتشغيل.
ولا توجد أسعار مبيعات معلنة مخصصة للسوق التركية لهذه النماذج. فهي ليست منتجات اشتراك موجهة إلى المستهلك النهائي، بل أدوات مخصصة أساسًا للباحثين والمطورين من المؤسسات.
وتكمن أهمية إطلاق Cosmos 3 في تنويع أدوات تطوير الذكاء الاصطناعي المتصل بالعالم الفيزيائي، وليس في جعل السيارات ذاتية القيادة أو الروبوتات أكثر قدرة فورًا. فنجاح البيانات الاصطناعية في بيئة الاختبار لا يثبت وحده مستوى الأمان في الواقع، وستظل الاختبارات الفيزيائية والتحقق من تطابق المحاكاة مع العالم الحقيقي جزءًا أساسيًا من عملية التطوير.
المصدر: shiftdelete